

Introducing LFM3: Every Modality for Specialized Intelligence | Blog | Liquid AI
LFM3 is Liquid AI’s new open-weight model family: 2B-class text, vision, audio, omni, and decision models built to fine-tune and run fast on any device.
AI開発企業のLiquid AIが2026年10月27日に、文章を扱う小さなAI「LFM3-1.7B」を発表しました。
長い文章を読ませるほどメモリを使うAIは、スマホの中だけで動かすのが難しくなります。
Liquid AIによると、LFM3-1.7Bは長い資料を読んだときのメモリが、比べた2つのAIより小さくなっています。
AIに長い文章を読ませると、なぜメモリが足りなくなるのでしょうか。
読んだ量に応じてAIのメモリは増える
AIは読んだ内容を、全部そのまま頭に入れておくんだと思ってた。
全部じゃなくて、語ごとの記録を取っておくんだ。
ふつうのAIは、次の語を作るたびに、それまでに読んだ語を見直すからね。
ここでは、AIが文を区切った1つ分を語と呼ぶよ。
見直しの材料を入れておく場所が、KVキャッシュだよ。
読む語が増えるほど、KVキャッシュも大きくなるんだ。
長い資料を貼るたびに、メモリがどんどん埋まっていくんだね。
うん、長い入力でメモリが足りなくなる大きな原因の1つだよ。
LFM3は24層のうち全体を見る層が6つ
AIの中身は、同じ形の部品が何十段も重なってできていて、その1段を層と呼ぶんだ。
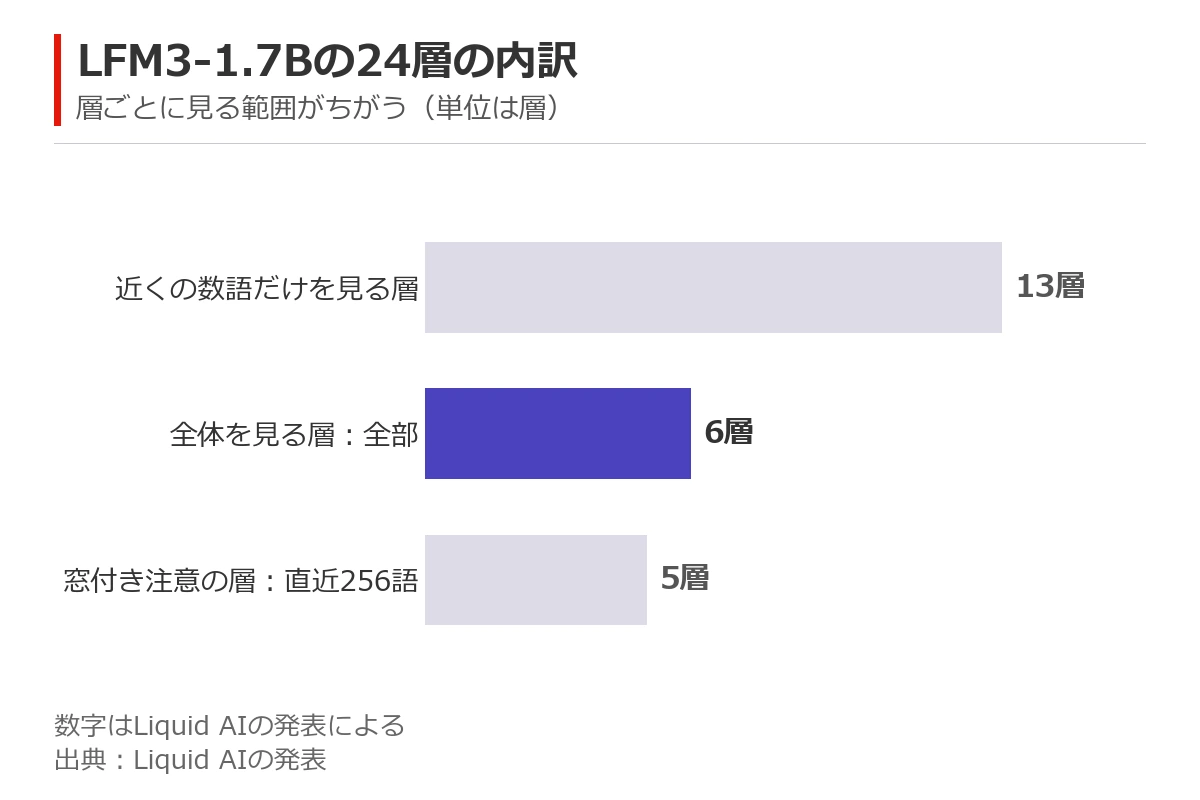
Liquid AIによると、LFM3-1.7Bは24層で、全部の語を見直す層は6つだけだよ。
この層を全体を見る層と呼ぶね。
残りは、近くだけを見る層なんだ。
直近256語だけを見る窓付き注意の層と、近くの数語だけを見る層があるよ。
Liquid AIは、賢さを足しても長い入力で遅くならないように、機械で作りを探したと書いているよ。
窓付き注意は、品質と速さのバランスがいちばんよかったんだって。
全体を見る層が少ないと、何がちがうの?
一般に、直近256語だけを見る層は、それ以前の語を見ないよ。
だから取っておく分も、256語ぶんで足りるんだ。
近くの数語だけを見る層も、取っておくのは近くの分だけだよ。
つまり、全体を見る層だけが、読んだ量に合わせて増え続けるってこと?
うん、読んだ量に応じて増えるのは全体を見る層だよ。
ただ、LFM3のKVキャッシュが小さい理由が層の数なのかは、Liquid AIは書いていないんだ。
LFM3は128K語でKVキャッシュ1.6GB
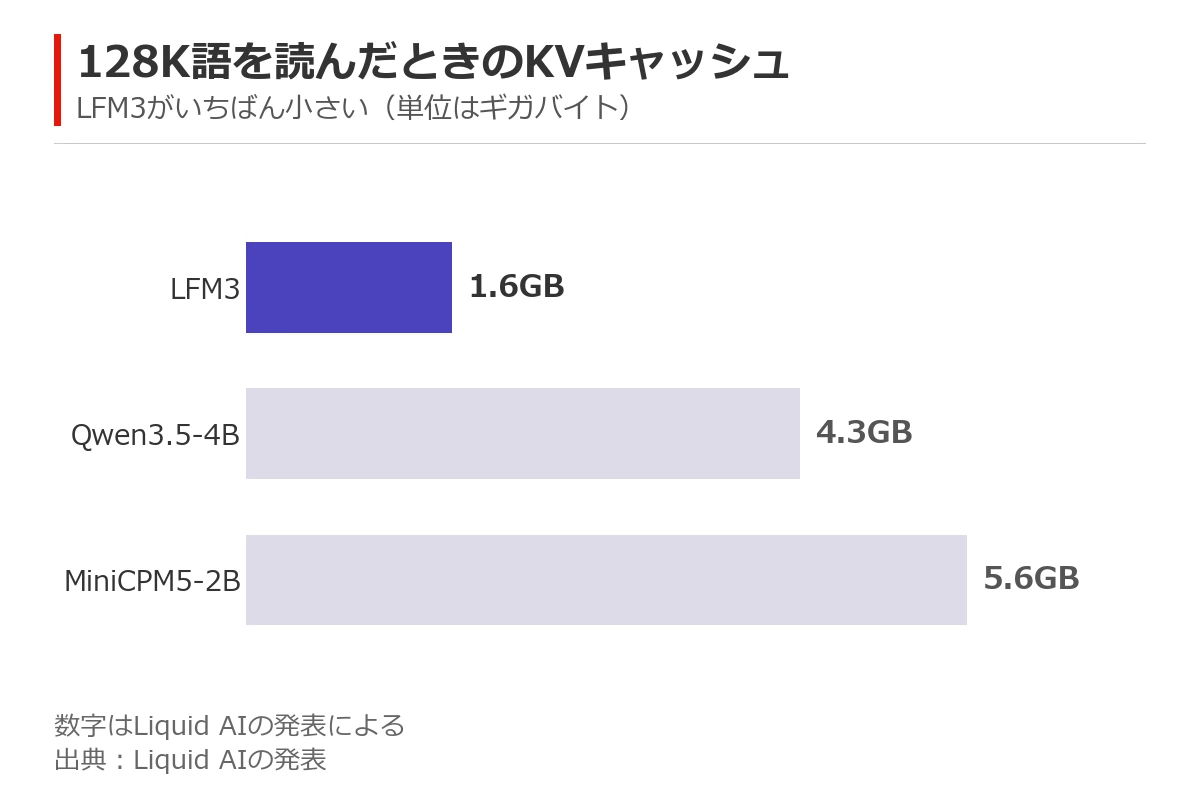
Liquid AIの発表では、LFM3のKVキャッシュは、128K語を読んだとき1.6GBなんだ。
Kは千を表すから、約13万語ぶんの長さだよ。
ほかのAIのKVキャッシュは、もっと大きいんだ。
Liquid AIの表では、Qwen3.5-4BはLFM3の2倍以上の大きさのAIなんだ。
モデル本体は、数を粗く保存する4bitの形にすると、約1GBのメモリを使うよ。
スマホやノートパソコンに入ると、Hugging Faceのモデルの説明にあるんだ。
長文の試験RULERではQwen3.5-4Bより低い
ただ、メモリが小さいことと、長い資料を正確に読めることは別なんだ。
え、そうなの?
RULER 128Kは、Liquid AIの表の「長い文脈」の項目にある試験だよ。
Liquid AIの表では、いちばん大きい数字に太字が付いているよ。
大きいほどいい成績で、LFM3は65.56、Qwen3.5-4Bは84.63なんだ。
MiniCPM5-2Bは37.96で、LFM3より低いよ。
同じ項目のAA-LCRは、LFM3が52.83で、Qwen3.5-4Bが52.67だよ。
LFM3がわずかに上で、差は小さいんだ。
どの数字も、Liquid AIが自分で出した値なんだ。
小さいことと正確なことは、分けて見ないといけないんだね。
まとめ
- Liquid AIが2026年10月27日に、小さなAI「LFM3-1.7B」を発表した
- 読んだ語を全部見直す層は、読んだ量に応じてKVキャッシュというメモリが増える
- LFM3は24層のうち全体を見る層が6つで、残りは近くだけを見る層
- Liquid AIによると、128K語を読んだときのKVキャッシュは1.6GB
- 長文の試験RULER 128Kでは、LFM3の65.56はQwen3.5-4Bの84.63より低い。同じ長文の項目のAA-LCRは差が小さい
長い入力でメモリが増える大きな原因の1つは、読んだ語を全部見直す層が情報を取っておくことです。LFM3は、全体を見る層が24層中6つで、残りは近くだけを見る層という作りです。
LFM3の数字と作りの説明は、Liquid AIの発表と、Hugging Faceのモデルの説明によります。
語の情報を取っておく仕組みと、層ごとの見る範囲がメモリに与える影響は、一般的な説明です。この2つの資料には書かれていません。