
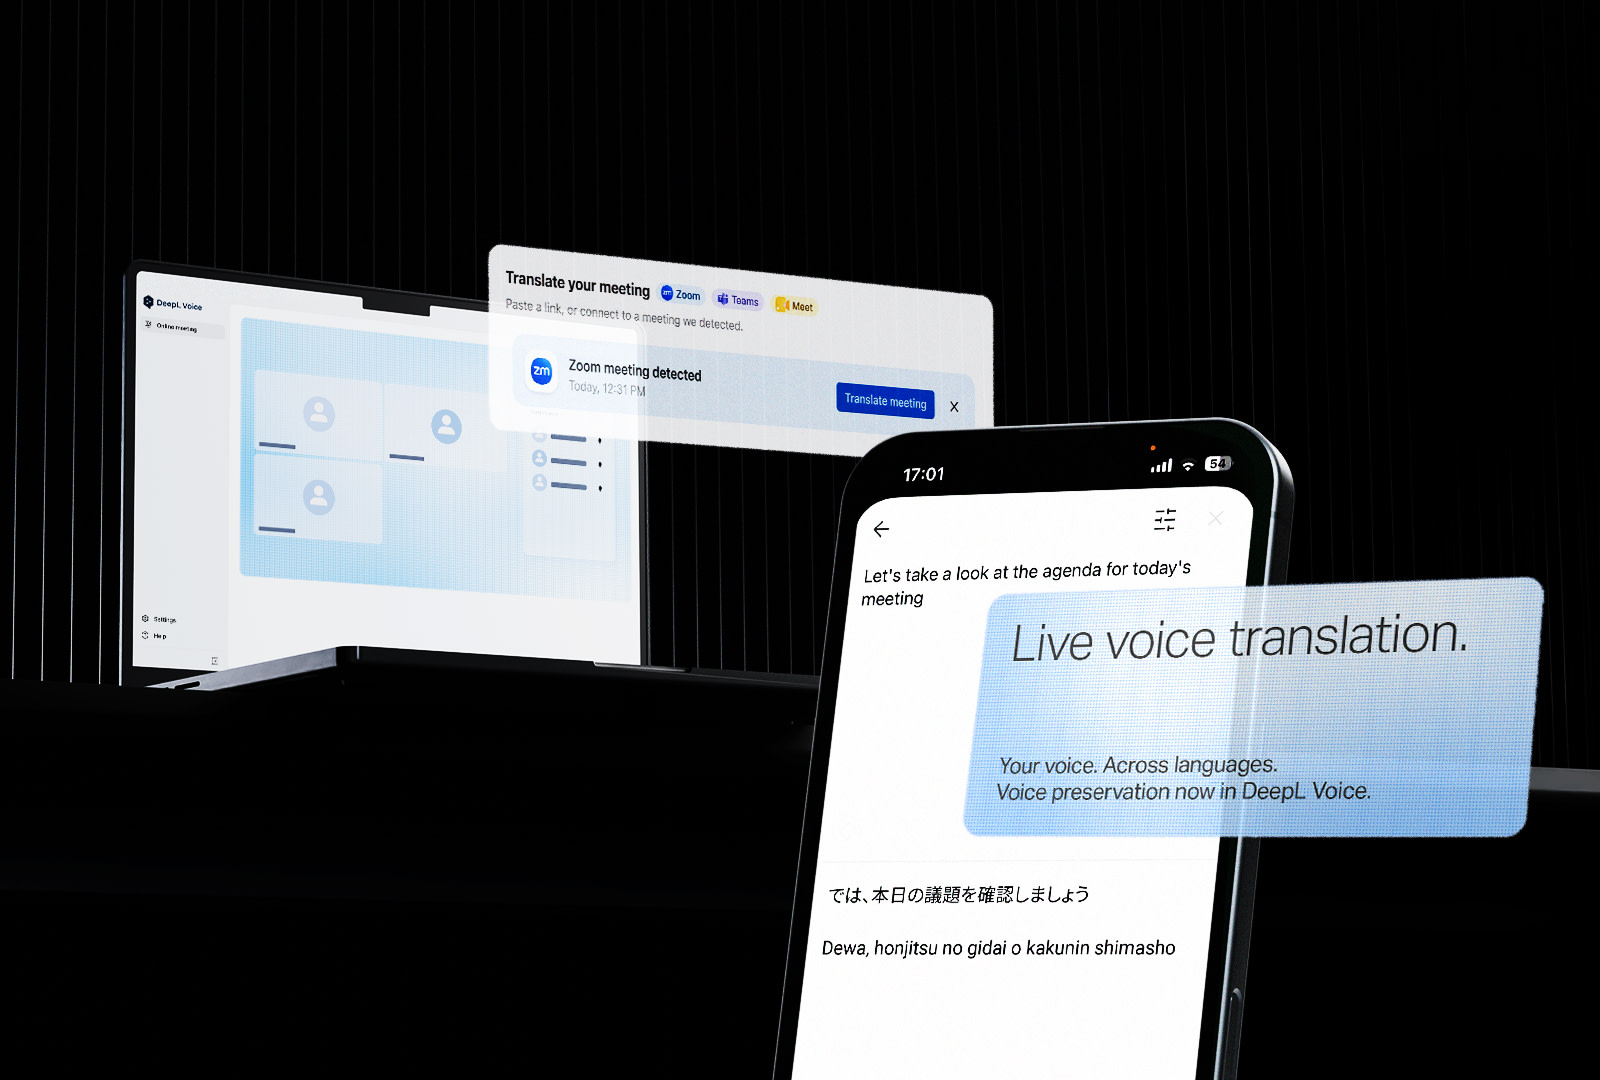
DeepL Voiceでは、言語を問わず、リアルタイムで話者の声をそのまま再現できるようになりました
リアルタイム音声翻訳により、言語を問わず各話者の語調や声のニュアンスを再現できるようになりました。Zoom、Teams、Google Meetに対応した統合デスクトップアプリもご利用いただけます。
海外の人とオンライン会議をするとき、訳した音声がみんな同じ機械の声だったら、誰が話しているのか迷いそうです。
DeepLは2026年9月15日、音声翻訳サービス「DeepL Voice」の新しい音声モデルを発表しました。音声モデルは訳した声を作る仕組みで、今回のものは話し手の声を保ったまま外国語で話します。
自分の声のまま外国語になるとは、どういうことなのか。声をまねされる心配はないのか。この2つを順に見ていきます。
そもそも音声翻訳は、訳した文を機械の声で読み上げるもの
音声翻訳は、話した言葉を別の言語に訳し、音にして相手に届ける仕組みです。たとえるなら、隣にいる通訳の人が、訳した中身を代わりに話してくれるようなものです。
ただし、話しているのは人ではありません。機械が作った声で、これを合成音声と呼びます。
DeepLは今回、「翻訳のたびに同じ合成音声が流れる」形との違いを挙げました。同じ合成音声なら、話す人が何人いても聞こえる声は1つです。だから、音だけでは誰の発言か分かりにくくなります。今回変わったのは、そこです。
自分の声のまま訳されると、誰が話したか聞き分けられる
新しいモデルは、話し手ひとりひとりの声や話し方を保ったまま言語を替えます。DeepLによると、複数の参加者がいる会話でも、それぞれの声を区別できるようになります。
さらに、届くのは声の質だけではありません。DeepLによれば、質問は質問らしく聞こえ、興奮した口調もそのまま伝わります。ためらい、強調、急いでいる感じ(切迫感)も残るとしています。
それで何がうれしいのか。たとえば同じ「いいよ」でも、明るく言うか、迷いながら言うかで、伝わる気持ちは変わります。DeepLも、誰が話しているか、どんな調子やペースで話すかが、相手の本当の考えの受け取り方に影響すると書いています。訳した中身だけでなく、言い方まで相手に届くということです。
DeepLはこれまで、まず訳の正しさに力を入れてきたと書いています。その目安として、DeepLは翻訳の誤り率を紹介しています。誤り率は、小さいほど訳の間違いが少ないことを表す数字です。
この数字は、DeepL自身ではなく、Slatorが独立して行ったテストのものです。そのテストで、誤り率はDeepL Voiceが4%でした。会議アプリのMicrosoft Teams、Google Meet、Zoomは、平均で17%です。
つまりDeepLは、訳の正しさの上に、今回は話し手らしさを足そうとしています。
声をまねされて怖くない?声の見本を残さない作り
声をまねできると聞くと、自分の声を勝手に使われないか、少し心配になります。人の声をまねるなら、その人の声を先に録って登録しておく必要がありそうに思えるからです。
ところがDeepLは、その必要がないと書いています。
「音声サンプルを保存したり、後で使用するための音声プロファイルを作成したりする必要がない」(DeepLのブログより)
たとえるなら、音声サンプルは声の録音見本、音声プロファイルは声の特徴を書きとめたカルテのようなものです。そしてDeepLは、この2つを作らなくてよいことを、データの安全が守られる理由として挙げました。
では、見本なしでどうやって声を写すのでしょうか。その中身は、DeepLのブログには書かれていません。
手がかりは、ニュースサイトのCNET Japanの記事にあります。CNET Japanによると、声の再現の参考にするデータは会議中の話し声です。
CNET Japanが伝えたDeepLの説明では、そのデータはメモリー(一時的な置き場)だけで持ち、会話の後に捨てます。別の会議に引き継ぐこともありません。

日本語で話せば「自分の声」のまま外国語に DeepLが新音声翻訳を提供開始 - CNET Japan
DeepLは9月15日、日本語などで話した内容を、話し手の声の特徴や話すテンポを保ちながら別の言語の音声で届ける機能を「DeepL Voice」で提供を開始したと発表した。Zoom、Microsoft Teams、Google Meetに対応するWindows/Mac向けアプリも提供を開始した。

つまり、その場で聞いた声をその場で使い、会話が終われば手元に残さないということです。声の扱いについてDeepLが示したのは、見本をためこまない作りでした。
会議アプリ向けのデスクトップアプリと、声を再現できる言語
あわせてDeepLは、WindowsとMac向けのDeepL Voiceのデスクトップアプリも出しました。対応するのは、Zoom、Microsoft Teams、Google Meetの3つです。
アプリは打ち合わせの開始を自動で見つけ、ワンクリックで翻訳を始めます。利用者は、訳された字幕を読むか、訳された音声を聞くか、両方を切り替えるかを選べます。
このアプリを通した音声翻訳は、正式な提供が始まりました。しかし、会議に外から加わる人(外部の参加者)がブラウザで使う音声翻訳は、まだ試験中のベータ版です。
声の再現が使えるのは、DeepLの発表では当初12言語で、今後増やす予定です。CNET Japanは14言語と伝え、その中に日本語も入っています。
まとめ
- DeepL Voiceの新しい音声モデルは、話し手ごとの声や話し方を保ったまま言語を替える
- 翻訳のたびに同じ合成音声が流れる形と違い、誰が話しているかを音で聞き分けられる。質問の調子やためらいも伝わる
- DeepLは、音声サンプルの保存も、声の特徴の記録づくりも要らないと書き、データの安全が守られる理由に挙げた
- CNET Japanによると、声の再現に使うのは会議中の話し声。DeepLの説明ではメモリーの中だけで持ち、会話の終了後に捨てる
- DeepL Voiceの翻訳の誤り率は、Slatorが独立して行ったテストで4%。会議アプリのMicrosoft Teams、Google Meet、Zoomの平均は17%
声をまねるには、声の見本をためておく必要がありそうに見えます。しかしDeepL Voiceのやり方は、その逆でした。その場の話し声を参考にして、話し手ごとの声のまま訳します。CNET Japanが伝えたDeepLの説明では、その声は会話が終われば捨てられる作りです。
この記事の内容は、DeepLの発表(2026年9月15日)によります。声の再現に使う話し声の扱いは、CNET Japanの記事(2026年9月16日)によります。